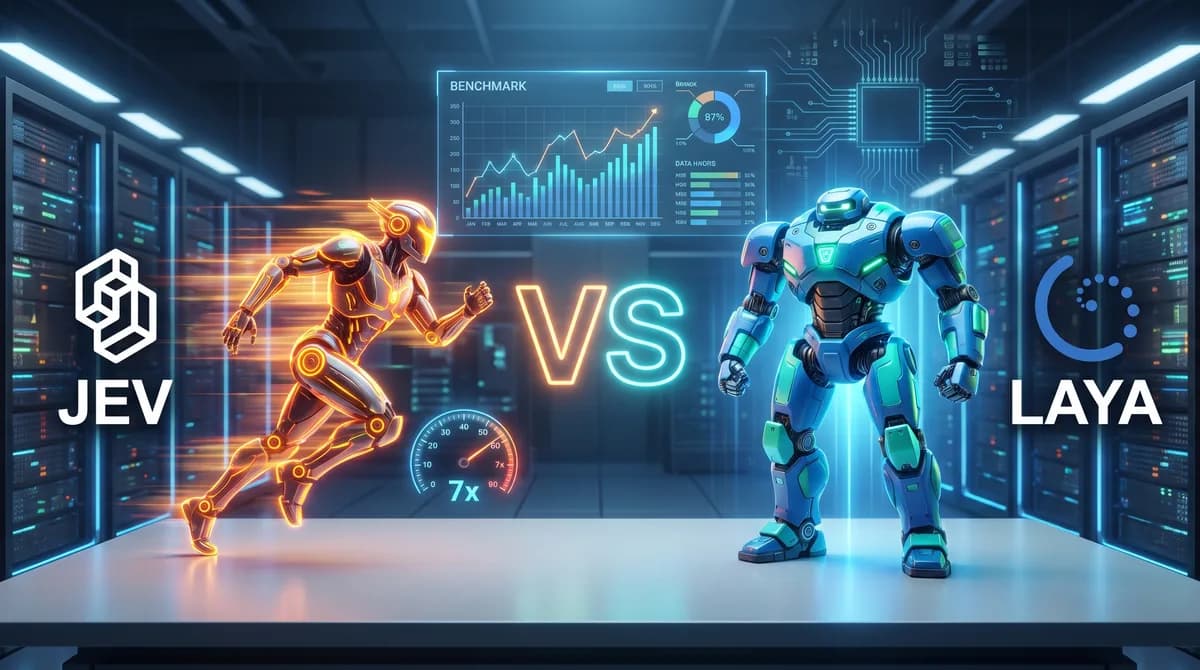
Jev vs Laya: o Modelo Open-Source Que Promete Ser 7x Mais Rápido, e os Detalhes Que o Benchmark Não Conta
Entre na sua conta para curtir e guardar o que gostou.
Jev vs Laya: o Modelo Open-Source Que Promete Ser 7x Mais Rápido, e os Detalhes Que o Benchmark Não Conta
Entre na sua conta para curtir e guardar o que gostou.
Jev vs Laya: o Modelo Open-Source Que Promete Ser 7x Mais Rápido, e os Detalhes Que o Benchmark Não Conta
0:00 / 16:08A Laya chegou três dias depois do Jev prometendo ser 7,8x mais rápida, mais precisa e grátis. Os números são reais, mas a precisão vem de treino e a velocidade de placa de vídeo. O que é a Laya, onde o Jev ainda ganha e qual usar.
Em 15 de setembro de 2026, a TypeSafe AI lançou o Jev, um modelo que não escreve texto: ele só decide, em milissegundos, e devolve a resposta num formato que o programa entende. Três dias depois apareceu no GitHub a Laya, um modelo aberto com a mesma proposta. Em cinco dias, ela passou de 19 mil estrelas e virou manchete: 7,8 vezes mais rápida que o Jev, mais precisa e de graça.
Os números existem, e estão no próprio repositório da Laya. A conclusão que está circulando é que está errada. Eu li o README inteiro, os portes para Mac e os benchmarks, e o detalhe mais importante está escrito lá pelo próprio autor: a Laya é uma base para você treinar, não um motor pronto para usar. Abaixo, o que é cada um, onde cada um ganha e qual faz sentido no seu caso.
O que é a Laya e como ela se compara ao Jev
Os quatro detalhes que o benchmark viral não conta
Onde o Jev ainda ganha com folga
A Laya rodando em 3,7 ms num Mac
Qual usar no seu projeto, caso a caso
O que é a Laya
A Laya é um modelo de decisão de código aberto, com licença Apache 2.0, criado pela Convai Innovations. Como o Jev, ela recebe um texto e perguntas tipadas (escolha entre opções, nota numa escala ou verdadeiro e falso) e responde todas de uma vez, numa única passada, sem gerar texto. Por isso não tem o que alucinar nem o que interpretar.
É a categoria que a TypeSafe chamou de modelos "System One", que eu expliquei em detalhe no post sobre o que é o Jev e como usar. A diferença da Laya é que os pesos são públicos: você baixa o modelo e roda onde quiser. O repositório oficial da Laya traz três versões e um roteador que escolhe a certa para cada pedido:
Versão | Base | Parâmetros | Contexto | Para quê |
|---|---|---|---|---|
laya | ModernBERT-large | 421 milhões | 512 tokens | Inglês |
laya-multilingual | mmBERT-base | 322 milhões | 1.024 tokens | Mais de 100 idiomas, incluindo português |
laya-typed-decisions | ModernBERT-large | 421 milhões | 1.024 tokens | Treinada para os fluxos do benchmark de decisões tipadas |
Dois detalhes práticos chamam atenção. O primeiro: a Laya traz um servidor HTTP compatível com o formato do Jev, então quem já integrou o Jev troca o endereço e continua funcionando. O segundo: o modelo tem cerca de 400 milhões de parâmetros, o que é pequeno para os padrões de hoje e cabe numa placa de vídeo comum ou num Mac.
Jev e Laya lado a lado
O Jev é um serviço pago e fechado, acessado por API e ainda com lista de espera. A Laya é um modelo aberto, gratuito, que roda na sua máquina. O Jev aceita até 255 opções por pergunta sem ajuste; a Laya perde precisão com muitas opções. Em velocidade, a Laya ganha com folga numa placa de vídeo, mas não no processador comum.
Critério | Jev | Laya |
|---|---|---|
Quem faz | TypeSafe AI | Convai Innovations (código aberto) |
Licença | Fechado, só por API | Apache 2.0, pesos públicos |
Preço | US$ 0,042 por milhão de tokens de entrada, saída grátis | Grátis; você paga a máquina |
Tempo por decisão | 236 a 276 ms (medição independente) | 32,8 ms em placa de vídeo T4; 193 a 464 ms só no processador |
Precisa treinar? | Não, funciona pronto | Sim, para ter a precisão divulgada |
Muitas opções | Até 255 por pergunta | Cai muito acima de 20 opções sem ajuste |
Onde os dados ficam | Saem para a API da TypeSafe | Na sua máquina |
Disponibilidade | Acesso antecipado, com lista de espera | Instala hoje com pip |
A linha da privacidade é a que mais pesa para empresa brasileira. Decidir se um e-mail de cliente é reclamação, cobrança ou pedido de cancelamento significa mandar o e-mail do cliente para algum lugar. Com a Laya, esse lugar é o seu servidor, e a conversa sobre LGPD fica bem mais simples.
O que o benchmark não conta
O benchmark que viralizou mistura números reais com uma leitura errada. O time da Laya nunca rodou o Jev, a precisão maior vem de um modelo treinado no próprio teste, a velocidade de 32,8 ms exige placa de vídeo e a calibração melhor depende de um ajuste extra. Os quatro pontos estão escritos no próprio README.
Não foi medido lado a lado. O README diz que os números do Jev foram publicados por terceiros e "nunca medidos aqui", porque o time não tem acesso à API da TypeSafe. As amostras e as perguntas são diferentes.
A precisão maior vem de treino. Os 0,766 contra 0,727 do Jev são da versão treinada com a parte de treino do próprio benchmark. As versões base, sem esse treino, ficam em 0,36, perto do chute aleatório de 0,318. O autor escreve com todas as letras: a Laya é "uma base rápida para especializar, não um motor de decisão zero-shot".
A velocidade tem placa de vídeo. Os 32,8 ms são numa placa T4. Só no processador, com o modelo já carregado, a Laya leva de 193 a 464 ms, a mesma faixa do Jev pela internet.
A calibração depende de ajuste. Sem ajuste, o Jev é mais bem calibrado no benchmark de decisões (erro de 0,144 contra 0,213). Depois de um ajuste de temperatura com dados do seu domínio, a Laya chega a 0,081. Do outro lado, o README registra que o Jev deu probabilidade zero à resposta certa em 16% dos casos num dos testes.
A Laya não é um Jev de graça. É uma base aberta que fica melhor que o Jev depois que você a treina no seu problema.
Isso não diminui a Laya. Um modelo aberto, rápido e treinável é exatamente o que muita empresa precisa. Mas muda a pergunta: não é "qual é melhor", é "você tem dados e tempo para treinar?".
Onde o Jev ainda ganha
O Jev ganha em três situações: perguntas com muitas opções, uso sem nenhum treino e quando você não quer manter infraestrutura. No teste de intenções bancárias, com 72 opções para o Jev e 77 para a Laya, o Jev acertou 0,870 e a Laya 0,425. O motivo é técnico: a Laya divide um espaço fixo de texto entre as opções, e com 77 delas sobram 3 ou 4 tokens para cada.
Muitas opções: o README sugere ampliar esse espaço, pré-filtrar as opções mais prováveis ou quebrar a pergunta em duas. Funciona, mas é trabalho seu.
Uso sem treino: para quem não tem exemplos rotulados, o Jev entrega a precisão divulgada no primeiro dia.
Distribuição de probabilidades: mesmo acertando mais a resposta principal, a Laya reproduz pior as probabilidades completas (0,471 contra 0,580 do Jev).
Zero operação: com o Jev, não tem servidor, placa de vídeo nem atualização de modelo para cuidar.
O preço também ajuda o Jev: US$ 0,042 por milhão de tokens é tão barato que, para volume pequeno, a conta de uma placa de vídeo nunca fecha. A comparação de custo com os modelos grandes, que cobram US$ 10 por milhão de entrada, está em GPT-6 Astra vs Claude Fable 5.1.
A Laya rodando num Mac
O que mais impressiona na Laya não veio do autor, e sim da comunidade. Em poucos dias apareceram portes independentes para o Mac: com o MLX, da Apple, uma decisão curta leva 13,4 ms num M3 Max; no Neural Engine, pelo Core ML, cai para 3,7 ms num M5 Pro. Tudo local, sem PyTorch e sem nuvem.
Laya MLX: 13,42 ms por pergunta curta em inglês e 7,39 ms na versão multilíngue, num M3 Max, com as mesmas respostas do original em 63 de 63 perguntas de validação. A demonstração joga Snake a 75 decisões por segundo.
Laya Core ML: cerca de 5 ms num M3 Max e 3,7 ms num M5 Pro, com quase toda a conta no Neural Engine, o chip de IA do Mac.
FluidUse: um aplicativo que lê formulários de outros programas pelo recurso de acessibilidade do macOS, pergunta à Laya o que vai em cada campo e preenche sozinho, sem nada sair da máquina.
Os três são projetos independentes, não versões oficiais, e o porte para MLX avisa que mediu fidelidade nas perguntas de validação, não precisão em qualquer pergunta. Mesmo assim, o recado é claro: decisão de agente rodando no próprio computador, em milissegundos, já é realidade. O porte da Laya para MLX tem os números e o método completos.
No golber.net eu sigo a mesma lógica numa ferramenta diferente: a de transcrever áudio roda o modelo Whisper dentro do navegador, e o arquivo nunca sai do computador de quem usa. Modelo pequeno rodando local é a tendência que eu já tinha apontado em como ganhar dinheiro com IA em 2027.
Qual usar no seu caso
Use a Laya se você tem dados do seu problema para treinar, precisa que as informações não saiam da sua infraestrutura ou vai tomar milhões de decisões por mês. Use o Jev se precisa de resultado sem treino, tem perguntas com dezenas de opções ou não quer manter servidor. Para a maioria dos projetos pequenos, começar pelo Jev e medir é o caminho mais curto.
Seu caso | Melhor escolha | Por quê |
|---|---|---|
Dados sensíveis de cliente, LGPD no centro | Laya | Nada sai da sua máquina |
Milhões de decisões por mês | Laya | Custo fixo da máquina contra custo por token |
Tem exemplos rotulados do seu problema | Laya | É com treino que ela passa o Jev |
Nenhum exemplo rotulado, quer resultado hoje | Jev | Funciona pronto |
Perguntas com 50 ou mais opções | Jev | A Laya precisa de ajuste para não perder precisão |
Aplicativo para Mac que decide sozinho | Laya | Os portes rodam em poucos milissegundos no Neural Engine |
Um cuidado para quem vai usar a Laya em português: texto muito curto, como "Quero cancelar" ou "Esqueci minha senha", pode não ter pistas suficientes do idioma, e o roteador manda para a versão em inglês por padrão. O próprio README ensina a trocar o padrão:
from laya import Router

# Tráfego em português: texto curto e sem pista de idioma vai para a versão multilíngue
router = Router(default="multilingual")
router.route({"body": "Esqueci minha senha"}).model  # -> multilingual
E, qualquer que seja a escolha, a decisão do modelo é só uma etapa. Quem age depois dela é o seu sistema, e os freios de um agente que decide sozinho estão em agentes de IA em looping infinito. O movimento de fundo, com o código aberto alcançando os modelos fechados em semanas, é o que descrevi em o que ganha tração no open source em 2026.
A disputa está só começando, e deixo as apostas registradas para conferir:
| Aposta | Confiança | Verificação | Resultado |
|---|---|---|---|
| Um benchmark independente publica Jev e Laya medidos com as mesmas perguntas, no mesmo teste, até 31 de outubro de 2026. | 60% | 31/10/2026 | Em aberto |
| A TypeSafe abre o Jev ao público, sem lista de espera, até 31 de dezembro de 2026. | 50% | 31/12/2026 | Em aberto |
| A TypeSafe reduz o preço do Jev para menos de US$ 0,042 por milhão de tokens de entrada até 31 de dezembro de 2026. | 40% | 31/12/2026 | Em aberto |
| A Laya publica uma versão que passa de 0,727 no benchmark de decisões tipadas sem ser treinada nele até 31 de dezembro de 2026. | 25% | 31/12/2026 | Em aberto |
Se você quer colocar um modelo de decisão no seu sistema, seja o Jev pela API ou a Laya rodando no seu servidor, com os dados, o treino e os freios no lugar certo, é o tipo de projeto que eu desenho com você numa consultoria técnica de 2 horas.
Perguntas frequentes
O que é a Laya?
A Laya é um modelo de decisão de código aberto, com licença Apache 2.0, da Convai Innovations. Ela responde perguntas tipadas sobre um texto (escolha, nota ou verdadeiro e falso) numa única passada, sem gerar texto, e roda na sua própria máquina, em mais de 100 idiomas.
A Laya é melhor que o Jev?
Depende do caso. Treinada no seu problema e rodando numa placa de vídeo, a Laya é mais rápida e pode ser mais precisa que o Jev. Sem treino, ela fica perto do chute aleatório no benchmark de decisões tipadas, e com dezenas de opções por pergunta o Jev ganha com folga.
A Laya é de graça?
Sim. Os pesos e o código são abertos, com licença Apache 2.0, e podem ser usados comercialmente. O custo é o da máquina onde ela roda, que precisa de placa de vídeo ou de um Mac com Apple Silicon para chegar à velocidade divulgada.
Quanto custa o Jev?
O Jev custa US$ 0,042 por milhão de tokens de entrada, com a saída grátis. Em setembro de 2026, ele está em acesso antecipado, com lista de espera, e a TypeSafe diz que o preço pode cair.
A Laya roda no Mac?
Roda, por portes independentes. Com o MLX, uma decisão curta leva cerca de 13 ms num M3 Max; pelo Core ML, no Neural Engine, cerca de 3,7 ms num M5 Pro. Esses portes não são versões oficiais da Convai Innovations.
A Laya funciona em português?
Funciona pela versão multilíngue, que cobre mais de 100 idiomas. Para textos curtos em português, vale configurar o roteador para usar a versão multilíngue por padrão, porque ele pode confundir frases curtas com inglês.
Golber Dóriaquem escreve este blog
Receba os posts novos no seu email
IA aplicada ao trabalho, stack e o negócio de uma pessoa só, direto na sua caixa de entrada. Sem spam, e sair é um clique em qualquer email.