Robots.txt Contra Treino de IA: o Sinal Único de Google, Microsoft, OpenAI e Anthropic, o Trecho Exato e o Que Não Faz
Entre na sua conta para curtir e guardar o que gostou.
Robots.txt Contra Treino de IA: o Sinal Único de Google, Microsoft, OpenAI e Anthropic, o Trecho Exato e o Que Não Faz
Entre na sua conta para curtir e guardar o que gostou.
Google, Microsoft, OpenAI e Anthropic apoiam um sinal único no robots.txt contra treino de IA. O trecho exato, o prazo real de cada empresa, o que ele não faz, a exceção do Gemini e como publicar no WordPress e na Cloudflare.
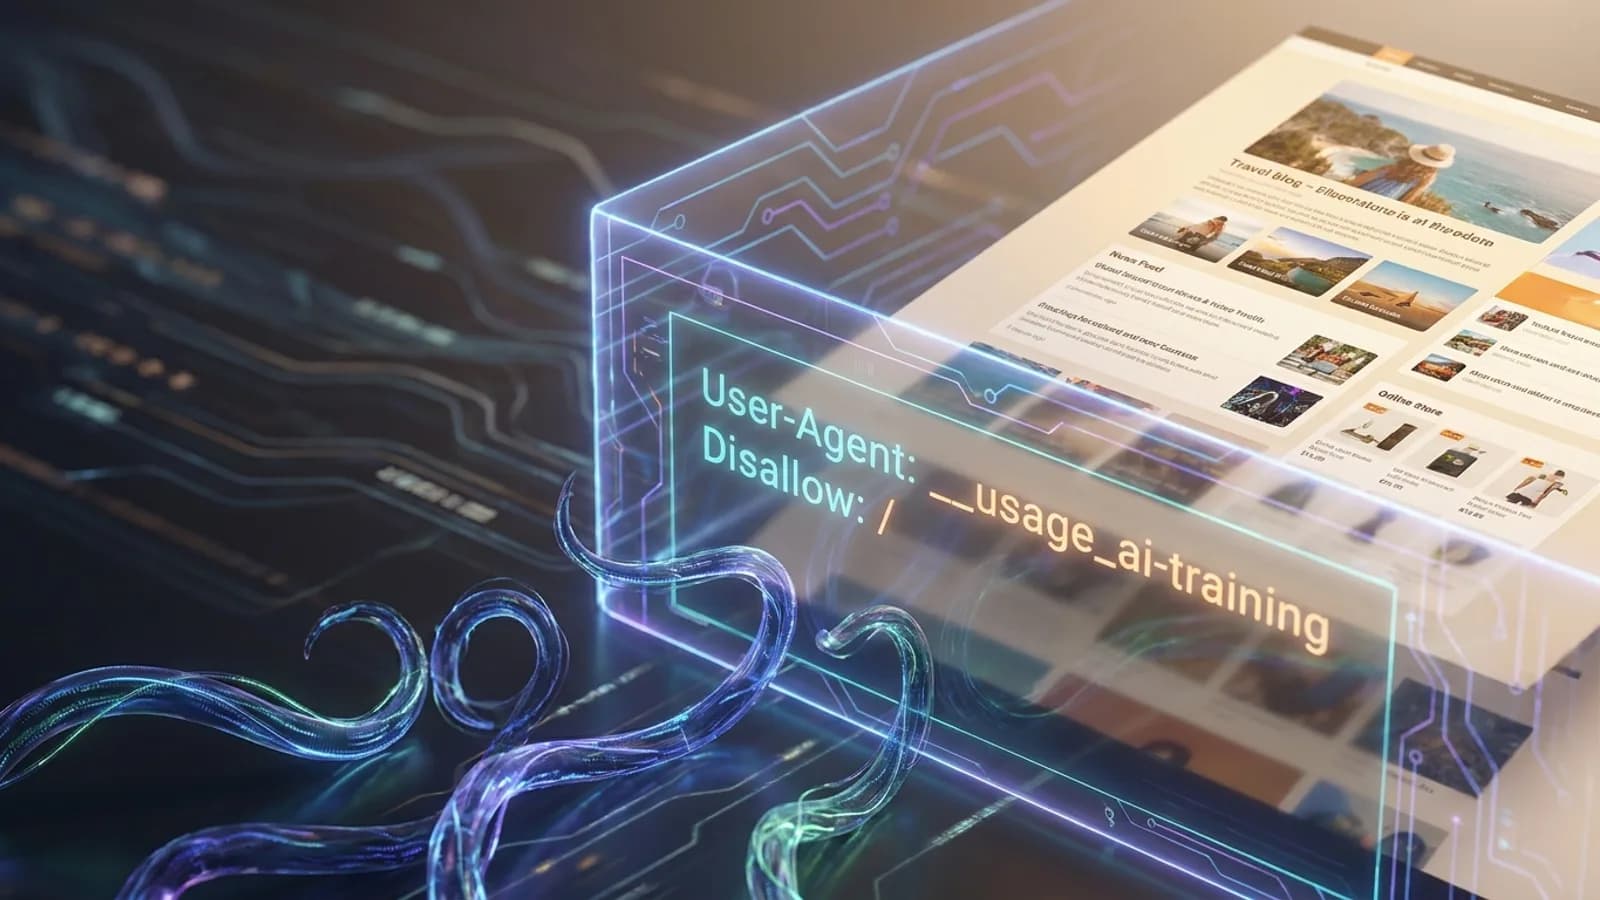
Para dizer às grandes empresas de IA que não quer seu site em treino de modelo, o novo caminho é um grupo com User-Agent: __usage_ai-training e Disallow: / no robots.txt. Google, Microsoft, OpenAI e Anthropic anunciaram apoio em 30 de outubro de 2026. É preferência, não bloqueio, e cada empresa entra em uma data.
Abaixo está o trecho exato, o calendário conferido nos anúncios originais, o que o sinal não faz, o caminho no WordPress e na Cloudflare e a decisão que importa: recusar treino sem sumir das respostas. Sobre a chave da Cloudflare em si, já escrevi em bloquear a IA de treinar sem sair do Google. Este post é sobre o sinal comum.
O trecho para colar, e o erro que derruba o site
O prazo real de cada empresa, porque as coberturas divergem
O que o sinal não faz, inclusive com o que já foi treinado
A exceção do Gemini, em que treino e citação andam juntos
Como publicar no WordPress e na Cloudflare
O trecho exato para o robots.txt
O sinal é um grupo comum de robots.txt, com o nome __usage_ai-training na linha User-Agent. Ele não cria comando novo: Disallow expressa preferência contra o treino naquele caminho, e Allow, preferência a favor. O grupo leva as próprias regras e vai no arquivo da raiz do domínio, de preferência depois dos grupos que já existem.
Para recusar treino no site inteiro:
User-Agent: __usage_ai-training
Disallow: /
Para recusar no site inteiro, menos uma pasta. Este é o exemplo do próprio rascunho publicado no IETF:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Para recusar só uma pasta, que é um dos exemplos do anúncio da Microsoft, troque o caminho:
User-Agent: __usage_ai-training
Disallow: /cursos/
A Microsoft também vai aceitar a preferência por página, com <meta name="Bingbot" content="ai-training:disallow">, que passa por cima do robots.txt naquela página. Em um arquivo de verdade, o grupo convive com os outros. Este é um robots.txt típico de WordPress com o sinal acrescentado no lugar certo:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-Agent: __usage_ai-training
Disallow: /

Sitemap: https://www.seusite.com.br/wp-sitemap.xml
Agora o erro que pode custar caro. Linhas User-Agent seguidas, sem regra entre elas, formam um grupo só, como diz o padrão do robots.txt. Se você empilhar o sinal embaixo do asterisco, o Disallow: / passa a valer para todos os robôs, inclusive o do Google:
# ERRADO: isto pede a todos os robôs que não rastreiem o site
User-agent: *
User-Agent: __usage_ai-training
Disallow: /
Duas linhas no lugar errado trocam uma recusa de treino por um pedido para sair do Google. Confira antes de salvar.
O calendário real de cada empresa
As coberturas divergem porque cada empresa publicou um prazo diferente. Nos textos originais, a Anthropic diz que já começou a reconhecer o sinal, a OpenAI fala em próximos meses, a Microsoft marca 1º de fevereiro de 2027 e o Google fala em 2027, com a documentação dizendo início do ano.
| Empresa | O que disse em 30/10/2026 | Prazo | Controle antigo que continua |
|---|---|---|---|
| Anthropic | Já começou a reconhecer, com expansão gradual aos serviços | Em andamento, sem data final | ClaudeBot |
| OpenAI | Pretende implementar e publicar os detalhes depois | "Nos próximos meses" | GPTBot |
| Microsoft | Vai honrar conforme o Bingbot rastrear cada página | A partir de 01/02/2027 | NoArchive e NoCache, até 01/03/2027 |
| Pretende apoiar e lerá o sinal como bloqueio do Google-Extended | 2027, início do ano segundo a documentação | Google-Extended |
As fontes de cada linha são a ajuda da Anthropic, o anúncio da OpenAI, o blog do Bing, o blog do Google Search Central e a documentação de rastreadores do Google.
Duas ressalvas de contexto. O texto base é um Internet-Draft individual de Kevin Kelley, da Anthropic, com validade até 3 de maio de 2027, sem endosso formal do IETF: é proposta, não padrão. E a lista tem só quatro nomes. Segundo o The Next Web, Andy Stone, chefe de comunicação da Meta, apoiou um sinal comum, mas não disse se a empresa vai respeitá-lo.
Por isso, a recusa completa hoje ainda usa as duas camadas. Nenhuma das empresas mandou apagar as regras antigas, e o Google e a OpenAI ainda não leem o sinal:
User-Agent: __usage_ai-training
Disallow: /

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Antes de copiar a última regra, leia a seção sobre o Gemini. E registro quatro apostas, com a chance estimada pelo Jev, o modelo de decisão que uso para probabilidades, a partir dos fatos de hoje, 5 de novembro:
| Aposta | Confiança | Verificação | Resultado |
|---|---|---|---|
| A Microsoft mantém 1º de fevereiro de 2027 como início do respeito ao sinal __usage_ai-training, sem anunciar adiamento | 75% | 01/02/2027 | Em aberto |
| Até 28 de fevereiro de 2027, a OpenAI ainda não publicou a atualização dizendo que implementou o sinal | 85% | 28/02/2027 | Em aberto |
| Até 31 de março de 2027, a documentação do Google ainda fala do sinal no futuro, sem dizer que já o respeita | 81% | 31/03/2027 | Em aberto |
| Até 30 de junho de 2027, a Meta não declara oficialmente que respeita o sinal | 91% | 30/06/2027 | Em aberto |
O que o sinal faz e não faz
O sinal diz uma coisa só: você prefere que o conteúdo daquele caminho não seja usado para treinar modelo generativo. Ele não impede o robô de entrar, não apaga o que já foi treinado, não obriga quem não aderiu e não trata de citação. É um pedido público, sem trava técnica.
Não é bloqueio. O rascunho é literal: o sinal não é uma diretiva de rastreamento. E a própria Cloudflare lembra que obedecer ao robots.txt é voluntário.
Não é retroativo. Valem as preferências do arquivo em vigor quando o conteúdo foi obtido. A Microsoft fala em treino futuro, a Anthropic em materiais futuros, e nos anúncios que li ninguém promete remover nada de modelo já treinado.
Não cobre toda IA. A definição é "modificar os parâmetros aprendidos de um modelo generativo". Modelo só de classificação ou ranking fica fora.
Não tira você da busca. A Microsoft diz que não muda a elegibilidade no Bing, e o Google diz que o Google-Extended não afeta a inclusão nem a classificação na Pesquisa.
Não paga ninguém. A Microsoft escreve que as preferências não criam licença nem pagamento. O mais perto disso hoje é o piloto em que o Google paga cerca de 100 sites, sem inscrição aberta.
Pode ser superado. O rascunho diz que acordos privados entre o site e a empresa podem valer por cima do sinal.
E uma regra que engana: User-agent: * com Disallow: / não conta como preferência de treino. O rascunho proíbe ler o asterisco como se fosse o sinal. Se o seu arquivo não tem a linha __usage_ai-training, você não expressou preferência nenhuma por esse mecanismo. Este post é técnico: se a dúvida for de direito autoral ou contrato, converse com um advogado.
Treino não é citação, com uma exceção
Treino muda o modelo; citação acontece na hora da resposta, quando a IA consulta a página. Na OpenAI e na Anthropic, os robôs são separados, e dá para recusar um e liberar o outro. No Google há um detalhe: o Google-Extended cobre também o uso em tempo real no app Gemini, e o sinal comum será lido como ele.
| Objetivo | OpenAI | Anthropic | Microsoft | |
|---|---|---|---|---|
| Recusar treino hoje | Disallow em GPTBot | Disallow em ClaudeBot | Disallow em Google-Extended | NoArchive ou NoCache, até 01/03/2027 |
| Continuar citado | Liberar OAI-SearchBot | Liberar Claude-SearchBot e Claude-User | Googlebot liberado e "Incluir" no Search Console | Não publicar preferência de grounding |
| Sair das respostas e ficar na busca | Disallow em OAI-SearchBot | Disallow em Claude-SearchBot e Claude-User | "Excluir" no Search Console | ai-grounding:disallow, por página |
A documentação da OpenAI faz duas ressalvas: quem bloqueia o OAI-SearchBot ainda pode aparecer como link de navegação, e as regras de robots.txt podem não se aplicar ao ChatGPT-User, porque a visita parte de um pedido do usuário. Já na busca do Google, quem manda é o controle "IA generativa na Pesquisa", em Configurações, no Search Console. Ele decide a presença na Visão Geral e no Modo IA, e não afeta o treino.
A exceção é o app Gemini. A documentação do Google diz que o Google-Extended controla o treino de modelos Gemini e também o grounding, que é levar conteúdo do índice ao modelo na hora da pergunta, nos apps do Gemini e no Vertex AI. O anúncio de 30 de outubro reforça: sites que permitem o Google-Extended de forma específica podem aparecer nas respostas e receber cliques por esse caminho. Na prática, quando o Google passar a ler o sinal, quem recusar por ele tende a sair também dessa fonte de citação. O mesmo vale hoje para quem bloqueia o Google-Extended.
Isso acrescenta algo ao que escrevi no post da Cloudflare. Lá tratei treino e citação como chaves separadas, o que continua certo para OpenAI, Anthropic e para a busca do Google. O app Gemini é o ponto que aquele post não cobriu. Para recusar treino nos outros e continuar elegível no Gemini, o Google deixa você escolher assim, sabendo que libera o treino dele junto:
User-Agent: __usage_ai-training
Disallow: /

User-agent: Google-Extended
Allow: /
O mesmo vale ao contrário. Regra que nomeia o robô vence o sinal: a Anthropic segue o que estiver em ClaudeBot "mesmo que a configuração geral diga algo diferente", e o Google só aplica o sinal se o Google-Extended não estiver no arquivo. Se você colou uma lista que libera todos os robôs de IA para "aparecer no ChatGPT", ela pode anular a sua recusa.
Bloquear treino ou querer ser citado?
Na maioria dos casos não é preciso escolher, porque são controles diferentes: dá para recusar treino e continuar citado. A escolha real aparece em dois pontos: o app Gemini, em que o mesmo controle cobre as duas coisas, e a sua aposta sobre valer ou não a pena estar no conhecimento do modelo.
Você vive de ser encontrado (negócio local, consultoria, loja, blog de autoridade): mantenha busca e citação abertas, porque é daí que vem o link. Recuse treino se isso for importante para você, e decida o Gemini pelo peso dele no seu público.
Você vive do conteúdo em si (curso, pesquisa, reportagem exclusiva): recuse treino. E não confie só no robots.txt: conteúdo pago fica atrás de login.
Você quer a marca conhecida pelo modelo: permitir treino é uma aposta legítima. Só não espere retorno garantido, porque a Microsoft escreve que nenhuma das escolhas garante inclusão, tráfego ou pagamento.
Você nunca pensou nisso: não fazer nada significa não expressar preferência, e na Microsoft o padrão é permitir.
O erro que eu evitaria é o oposto do que parece seguro: bloquear OAI-SearchBot, Claude-SearchBot ou o controle do Search Console achando que está protegendo o conteúdo. Isso não muda o treino e tira você das respostas. O guia de GEO mostra como esse bloqueio acidental é comum, e o post sobre a guerra pela busca explica por que a citação virou disputa de dinheiro.
Como publicar no WordPress e na Cloudflare
Em qualquer site, o objetivo é o mesmo: o trecho precisa aparecer em seusite.com.br/robots.txt. No WordPress, isso se faz por plugin de SEO, por arquivo na raiz ou por código. Na Cloudflare, o arquivo da sua origem é mantido, e o bloco gerenciado entra antes dele. Os menus abaixo vêm das ajudas oficiais.
No WordPress
Sem arquivo físico, o WordPress monta o robots.txt sozinho. Escolha um caminho só. As ajudas dos plugins usam os nomes em inglês, e no painel traduzido o rótulo pode mudar.
Pelo Yoast SEO:
No painel, vá em Yoast SEO e depois em Tools.
Abra File Editor. O menu não aparece se a edição de arquivos estiver desativada no WordPress.
Se ainda não houver arquivo, clique em Create robots.txt file.
Acrescente o grupo no fim do arquivo e salve.
Pelo Rank Math:
No painel, abra Rank Math SEO e confirme que o Advanced Mode está ativo, no canto superior direito.
Vá em General Settings e depois em Edit robots.txt.
Acrescente o grupo no fim do arquivo e clique em Save Changes.
O Rank Math edita um arquivo virtual, e a ajuda dele recomenda excluir o robots.txt real da raiz, por FTP, para editar pelo plugin. Sem plugin, crie ou edite esse arquivo real na raiz do site, pelo FTP ou pelo gerenciador de arquivos da hospedagem. Quem programa pode usar o filtro robots_txt, que só age quando o WordPress serve o arquivo virtual:
add_filter( 'robots_txt', function ( $output ) {
    return $output . "\nUser-Agent: __usage_ai-training\nDisallow: /\n";
} );
Já que abriu o painel, confira também a versão do PHP: o fim do suporte ao PHP 8.2 está perto.
Na Cloudflare
Se a sua origem já responde com um robots.txt, a Cloudflare põe o bloco gerenciado antes e mantém o seu. Então o sinal comum entra pelo arquivo da origem, como nos passos acima. Se não houver arquivo na origem, a Cloudflare cria um só com as regras dela, e o seu grupo não estará lá.
As páginas da Cloudflare que li, atualizadas em 2 de novembro de 2026, não citam __usage_ai-training. Não conte que a chave publique esse grupo por você. O que ela faz é outra coisa, com o caminho da documentação:
No painel, vá em Security e depois em Settings.
Filtre por Bot traffic e selecione AI Crawler and Agent access policies.
Em Training, selecione Disallow.
Ligue Enable Bot Preference Sync e clique em Save.
A diferença é que, com essa sincronização, o Disallow também bloqueia na borda os robôs de treino, menos os de finalidade mista. Aí existe trava técnica, e não só pedido. Só repare que o exemplo da documentação nomeia o Google-Extended com Disallow, o que traz de volta a exceção do Gemini.
Como conferir e o que pode dar errado
Abra seusite.com.br/robots.txt em uma aba anônima e veja se o grupo aparece igual ao trecho, separado dos demais. Se houver cache ou CDN, confira de novo depois de limpar. Publicar também não é ativar: a Microsoft avisa que a preferência só vale depois que o robô passar pela página.
Grupo empilhado embaixo de
User-agent: *: mova o grupo inteiro para o fim do arquivo, depois das regras do asterisco.Regras antigas apagadas cedo demais: mantenha GPTBot, ClaudeBot e Google-Extended enquanto as empresas não confirmarem a leitura do sinal.
Arquivo no lugar errado: ele fica na raiz de cada host, e a própria Anthropic pede a regra em cada subdomínio.
Procurar o robô no log: o rascunho diz que o nome
__usage_ai-trainingnão precisa aparecer em requisição nenhuma.Dúvida se o Google leu o arquivo: o relatório robots.txt do Search Console mostra a última verificação, os erros e permite pedir nova leitura.
O sinal é um passo útil, mas é pedido, com data diferente em cada empresa. O que define o resultado para o seu negócio é a combinação de robots.txt, Search Console e CDN, e é fácil uma camada desfazer a outra. Se você quer revisar isso com alguém que mexe nessas camadas todo dia, é o tipo de conversa que faço na consultoria técnica.
Perguntas frequentes
O que é __usage_ai-training?
É o nome que vai na linha User-Agent do robots.txt para expressar uma preferência sobre treino de IA generativa. Vem de um rascunho de 30 de outubro de 2026, publicado no IETF por Kevin Kelley, da Anthropic. Google, Microsoft e OpenAI anunciaram apoio no mesmo dia.
Esse sinal tira meu site do Google?
Não, se o grupo tiver as próprias regras. O Google vai lê-lo como bloqueio do Google-Extended, que não afeta a inclusão nem a classificação na Pesquisa. O risco é outro: empilhá-lo embaixo de User-agent: * faz o Disallow: / valer para todos os robôs.
O sinal já funciona hoje?
Em parte. A Anthropic diz que já começou a reconhecê-lo, de forma gradual. A OpenAI fala em próximos meses, a Microsoft em 1º de fevereiro de 2027 e o Google em 2027. Até lá, mantenha GPTBot, ClaudeBot e Google-Extended no arquivo, se quiser recusar treino.
Recusar treino me impede de ser citado pela IA?
Em geral, não: na OpenAI e na Anthropic há robôs separados para busca, e a busca do Google tem controle próprio no Search Console. A exceção é o app Gemini, porque o Google-Extended cobre treino e também o uso em tempo real nas respostas.
O sinal apaga o que a IA já aprendeu com meu site?
Não. Ele vale para o conteúdo obtido com a preferência em vigor, e os anúncios falam em treino futuro. Nos anúncios que li, nenhuma das empresas promete remover conteúdo de modelos já treinados por causa do sinal.
Preciso apagar as regras de GPTBot e ClaudeBot?
Não. As empresas dizem que os controles antigos continuam valendo, e a regra que nomeia o robô tem prioridade na Anthropic e no Google. Se essas regras dizem Allow, elas podem anular a recusa que você quis expressar pelo sinal comum.
Golber Dóriaquem escreve este blog
Receba os posts novos no seu email
IA aplicada ao trabalho, stack e o negócio de uma pessoa só, direto na sua caixa de entrada. Sem spam, e sair é um clique em qualquer email.